
„Nasz asystent twierdzi, że od zeszłego tygodnia oferujemy klientom bezpłatny serwis przez pięć lat!” – krzyczy do słuchawki zdenerwowany dyrektor sprzedaży. Otwierasz firmowy dysk, logujesz się do wewnętrznego systemu i od razu widzisz źródło pożaru. Obok oficjalnego, aktualnego regulaminu z 2026 roku leży stary, roboczy plik z 2021 roku o nazwie „Regulamin_poprawki_v2_DRAFT_Kopia.docx”. Algorytm przeszukał firmowe zasoby i uznał ten plik za najlepiej dopasowany do zadanego pytania. Nie dlatego, że był aktualny – ale dlatego, że nikt nie oznaczył, który dokument obowiązuje, a który jest porzuconym szkicem.
Firmowa baza wiedzy AI, zamiast stać się realnym wsparciem zespołu, w ten sposób zaczyna generować kosztowne pomyłki. Wielu menedżerów myśli, że wystarczy podpiąć model językowy pod dysk sieciowy, by zyskać genialnego asystenta. Bez odpowiedniej higieny danych sztuczna inteligencja nie stanie się jednak cyfrowym mózgiem, lecz rozgadanym pracownikiem, który bez wahania zmyśla fakty. W świecie technologii zjawisko to nazywamy architekturą RAG (Retrieval-Augmented Generation), czyli generowaniem odpowiedzi wspomaganym wyszukiwaniem wiedzy.
Spis treści
Dlaczego sztuczna inteligencja zmyśla, gdy dostaje nieuporządkowane pliki?

Sztuczna inteligencja nie czyta dokumentów tak jak człowiek. Model językowy nie przegląda wielostronicowych instrukcji od deski do deski podczas każdego zapytania. Zamiast tego system RAG tnie Twoje pliki PDF, arkusze kalkulacyjne i prezentacje na małe fragmenty tekstowe, nazywane chunkami. Kiedy pracownik zadaje pytanie w oknie czatu, algorytm szuka kilku najbardziej pasujących kawałków i na ich podstawie buduje odpowiedź.
Gdy w Twoich folderach panuje chaos, proces ten zamienia się w rosyjską ruletkę. Jeden dokument każe zadzwonić do działu reklamacji. Notatka sprzed trzech lat podaje już nieaktualny numer telefonu. Model może zlepić oba fragmenty w jedną odpowiedź albo bezkrytycznie zacytować ten starszy. Powstaje wtedy przekonująco brzmiąca halucynacja, która wprowadza zespół w błąd.
Sztuczna inteligencja nie ocenia autorytetu autora pliku na podstawie stażu pracy. Sam wektor semantyczny nie wie, czy fragment pochodzi z zatwierdzonej procedury, czy z niezatwierdzonego, roboczego szkicu sprzed lat. Dla algorytmu obie wersje mogą wydać się równie trafną odpowiedzią, jeśli używają podobnego słownictwa. Dopiero dodatkowe reguły – metadane, priorytety źródeł i filtry dostępu – uczą system rozróżniać obowiązującą prawdę od archiwalnego echa. To człowiek musi zbudować te ramy, w których model porusza się bezpiecznie.
Zjawisko szumu informacyjnego – dlaczego algorytm się gubi
W większości przedsiębiorstw dokumenty powstają spontanicznie. Pracownicy tworzą dziesiątki wersji tych samych procedur, zapisując je w prywatnych katalogach. Kiedy łączysz taki zasób z asystentem AI, algorytm musi wybrać kilka fragmentów spośród tego chaosu. Jeśli trafią się wśród nich sprzeczne, przestarzałe lub robocze wersje, model złoży z nich błędną, choć przekonującą odpowiedź.
Fragmentacja kontekstu
Proces dzielenia długich instrukcji na małe części potrafi rozerwać sens zdania. Jeśli tabela z cennikiem zostanie przecięta w połowie, algorytm przypisze cenę produktu A do opisu produktu B. Przygotowanie dokumentów polega na takim formatowaniu treści, aby każdy fragment zachował logiczną całość.
Brak datowania i problem zdezaktualizowanych wytycznych
Sama baza wektorowa nie rozumie, że notatka z 2019 roku jest mniej aktualna niż zarządzenie podpisane wczoraj. Bez wyraźnego nagłówka z datą i statusem obowiązywania system może potraktować archiwalne ustalenia jako obowiązujący standard obsługi klienta.
Trzy grzechy główne firmowej dokumentacji: Czego nie lubi asystent AI?
Przekształcenie rozproszonych plików w sprawny mózg organizacji wymaga zidentyfikowania przeszkód, które paraliżują systemy wyszukiwania semantycznego. Zwykły format pliku, który dla człowieka jest czytelny, dla algorytmu bywa barierą nie do przejścia. Dlatego menedżer musi spojrzeć na dokumenty oczami parsera tekstu, czyli narzędzia, które próbuje wydobyć z pliku jego strukturę i znaczenie.
Największym wrogiem automatyzacji są materiały nieprzetwarzalne maszynowo. Zeskanowane faktury bez warstwy tekstowej, wielopoziomowe tabele z połączonymi komórkami czy prezentacje pełne skrótów myślowych sprawiają, że asystent gubi wątek. Higiena wiedzy to fundament, na którym opiera się bezpieczne wdrożenie. Wyeliminowanie tych błędów nie wymaga wiedzy programistycznej. Wymaga wdrożenia standardów redakcyjnych, które każdy pracownik biurowy może zastosować podczas codziennego zapisywania notatek.
Zeskanowane pliki PDF bez warstwy tekstowej (OCR)
Wielu przedsiębiorców wgrywa do bazy wiedzy skany umów z podpisami. Dla większości standardowych systemów RAG zwykły plik graficzny zamknięty w formacie PDF wciąż jest praktycznie pustą stroną. Silnik nie odczyta z niego ani jednego paragrafu, dopóki tekst nie zostanie wydobyty przez OCR. Nowsze, multimodalne narzędzia potrafią „przeczytać” taki skan jak obraz i wykonać to rozpoznawanie automatycznie. Odpowiedzialny menedżer i tak powinien zweryfikować jakość takiego odczytu, zanim zaufa mu przy ważnych dokumentach.
Skomplikowane tabele i zagnieżdżone komórki
Modele językowe doskonale radzą sobie ze strukturą podmiot-orzeczenie. Zawiłe, wielowymiarowe tabele z Excela bywają dla nich za to prawdziwą pułapką. To nie dlatego, że model „nie rozumie” tabel. Winny jest raczej proces wydobywania i dzielenia tekstu, który często gubi po drodze ich strukturę. Połączenie komórek o różnej szerokości sprawia, że parser odczytuje dane w złej kolejności, mieszając kolumny z wierszami.
Wieloznaczne nazewnictwo i brak standaryzacji pojęć
Jeśli w jednym dziale ten sam proces nazywacie „onboardingiem”, a w innym „adaptacją pracownika”, asystent AI może uznać je za dwie odrębne procedury. Ujednolicenie słownika pojęć w plikach tekstowych drastycznie zwiększa precyzję wyszukiwarki semantycznej.
Standard Redakcyjny No-Code: Jak formatować dokumenty przed wgraniem do bazy?
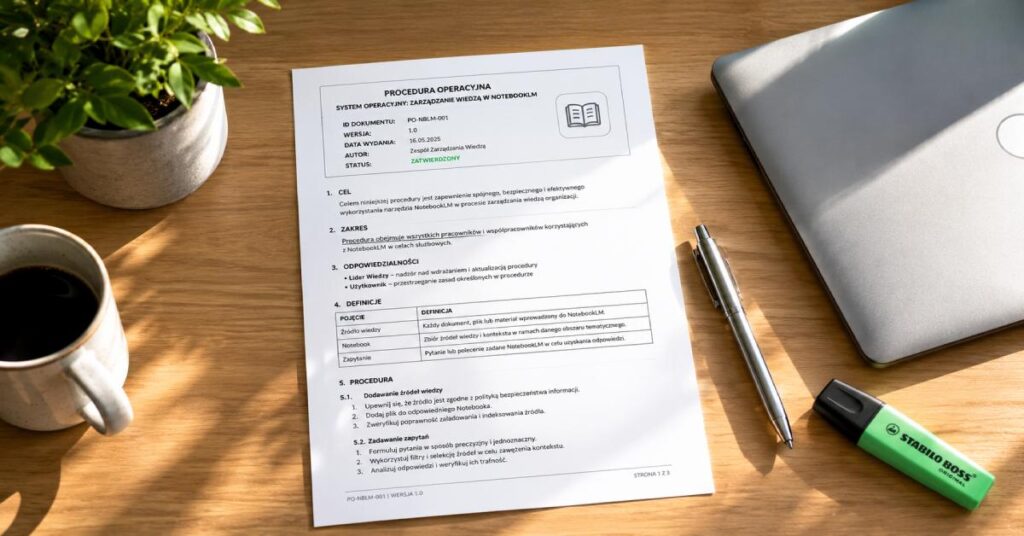
Aby ułatwić zespołowi przygotowanie materiałów, warto wdrożyć jednolity standard tworzenia dokumentów operacyjnych. Każdy plik Word lub Markdown trafiający do centralnego repozytorium powinien posiadać prostą, modułową strukturę. Dzięki temu algorytm wyszukiwawczy bez problemu przypisze właściwy kontekst do każdego akapitu.
Fundamentem czystej wiedzy jest stosowanie metadanych w nagłówku każdego dokumentu. Zanim przejdziesz do opisu procedury, umieść na samej górze strony prostą metryczkę informacyjną:
- Tytuł dokumentu: Precyzyjna nazwa procesu (np. „Procedura zwrotu towaru w sklepie internetowym”).
- Status i wersja: Oznaczenie aktualności (np. „Wersja 3.2 – Obowiązuje od 01.03.2026 r.”).
- Właściciel procesu: Imię, nazwisko i stanowisko osoby odpowiedzialnej za aktualizację wiedzy.
- Grupa docelowa: Działy, których te wytyczne dotyczą (np. „Biuro Obsługi Klienta, Magazyn”).
- Słowa kluczowe: Synonimy i terminy branżowe ułatwiające powiązanie faktów.
Kolejną zasadą jest zamiana rozbudowanych tabel na listy punktowane. Zamiast tworzyć skomplikowaną siatkę danych w Wordzie, opisz parametry w prostych zdaniach: „Produkt X: Cena 500 zł, Gwarancja 24 miesiące, Czas dostawy 48 godzin”. Taki zapis gwarantuje, że po pocięciu tekstu na mniejsze kawałki informacja zachowa pełny sens logiczny.
Scenariusze wdrożenia: Jak w praktyce wygląda porządkowanie firmowej bazy wiedzy
Teoria nabiera sensu dopiero w zderzeniu z konkretnymi wyzwaniami biznesowymi. Poniższe dwa scenariusze to modelowe przykłady. Pokazują mechanizm działania opisanych zasad w organizacjach typowych dla polskiego rynku. Traktuj je jako ilustrację kierunku zmian, a nie udokumentowany raport z pomiarów.
Scenariusz 1: Kancelaria prawno-finansowa i audyt 400 regulaminów
- Wyzwanie: Zespół doradców tracił średnio 45 minut na weryfikację zapisów w historycznych umowach klientów. Wdrożony asystent AI podawał nieprawidłowe stawki prowizji, opierając się na nieaktualnych aneksach.
- Co zrobiono: Menedżer procesów zarządził całkowity przegląd plików. Wszystkie archiwalne dokumenty przeniesiono do odizolowanego folderu „Archiwum_Cold”, a bieżące pliki opatrzono ujednoliconym nagłówkiem z datą i statusem prawnym. Tabele prowizyjne zamieniono na ustrukturyzowane listy tekstowe.
- Efekt: Liczba błędnych odpowiedzi asystenta spadła niemal do zera, a czas przygotowania analizy finansowej dla nowego klienta skrócił się z trzech godzin do około 20 minut.
Scenariusz 2: Sieć serwisów technicznych i wsparcie mechaników
- Wyzwanie: Nowi pracownicy infolinii technicznej podawali klientom sprzeczne instrukcje dotyczące procedur gwarancyjnych. Wynikało to z faktu, że baza wiedzy zawierała robocze notatki serwisantów w formacie nieczytelnych skanów.
- Co zrobiono: Firma wdrożyła automatyczne rozpoznawanie znaków (OCR) dla wszystkich archiwalnych schematów, a instrukcje napraw przepisano do ustandaryzowanego formatu z wyraźnymi nagłówkami krok po kroku. Wprowadzono zasadę kwartalnego przeglądu treści przez kierowników warsztatów.
- Efekt: Zadowolenie klientów z pierwszego kontaktu wyraźnie wzrosło, a czas wdrożenia nowego konsultanta skrócił się z czterech tygodni do około pięciu dni.
Trzypoziomowa architektura repozytorium: Jak posegregować firmowe foldery?
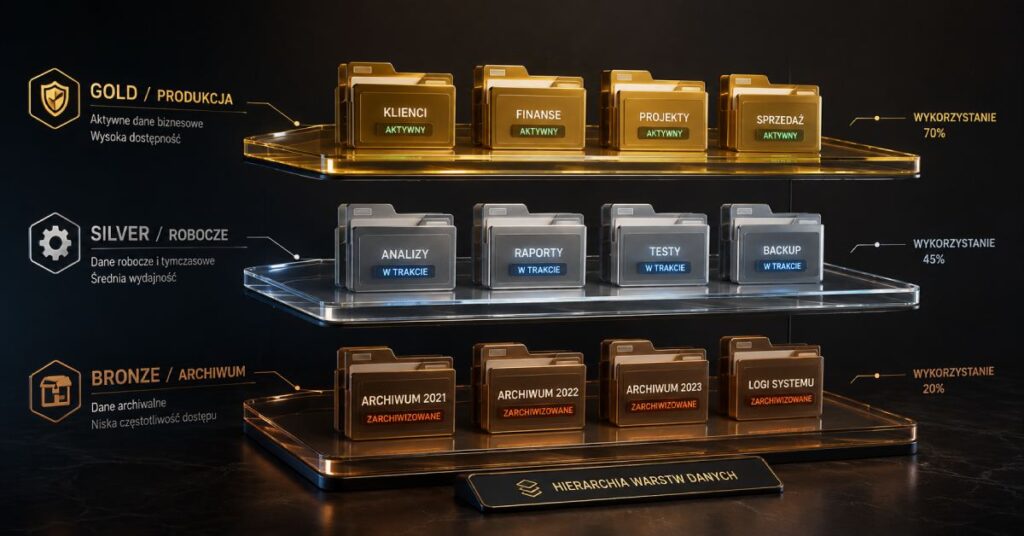
Aby asystent AI działał stabilnie w długiej perspektywie, musisz zbudować przejrzystą strukturę folderów na firmowym dysku. Zamiast wrzucać wszystkie pliki do jednego worka, zastosuj podział na trzy odrębne strefy dostępowe. Taka segmentacja ułatwia zarządzanie uprawnieniami i chroni model przed czytaniem niezatwierdzonych notatek.
| Strefa | Zawartość | Dostęp dla AI | Zasada nadzoru |
|---|---|---|---|
| Strefa 1: Czysta Prawda (Gold Standard) | Zatwierdzone regulaminy, oficjalne cenniki, aktualne procedury operacyjne, wzory umów. | Pełny dostęp z najwyższym priorytetem wyszukiwania. | Prawo edycji ma wyłącznie wyznaczony właściciel procesu (Knowledge Master). |
| Strefa 2: Warsztat Roboczy (Silver) | Notatki ze spotkań, szkice ofert, burze mózgów zespołów, projekty prezentacji. | Całkowity zakaz indeksowania przez głównego asystenta firmy. | Przestrzeń do swobodnej pracy bieżącej pracowników. |
| Strefa 3: Archiwum Historyczne (Bronze) | Nieobowiązujące cenniki, wygasłe umowy, stare wersje systemów. | Dostęp wyłącznie na specjalne żądanie w dedykowanym trybie audytorskim. | Pliki zabezpieczone przed przypadkową modyfikacją i oznaczone tagiem archiwalnym. |
Złota zasada: Twój asystent AI powinien czerpać wiedzę wyłącznie ze Strefy 1. Eliminujesz w ten sposób jedną z najczęstszych przyczyn błędnych odpowiedzi: dostęp modelu do nieaktualnych i niezatwierdzonych dokumentów.
Zanim uruchomisz asystenta: uprawnienia i zaufanie do odpowiedzi
Kto może zobaczyć dany dokument? (RODO i uprawnienia dostępu)
Sama segregacja plików na strefy to dopiero połowa pracy. Przed uruchomieniem asystenta AI ustal, kto w organizacji może zobaczyć poszczególne dokumenty. Sprawdź też, jakie dane osobowe i informacje poufne wolno indeksować oraz czy dostawca narzędzia spełnia wymogi bezpieczeństwa i RODO.
Kluczowa zasada brzmi: asystent powinien respektować dokładnie te same uprawnienia, które ma pracownik zadający pytanie. Konsultant z obsługi klienta nie powinien przez czat z AI uzyskać dostępu do danych kadrowych czy warunków handlowych. Jeśli nie mógłby otworzyć pliku ręcznie na dysku, asystent też nie powinien mu go pokazać.
Cytowanie źródeł i prawo do odpowiedzi „nie wiem”
Poza porządkiem w plikach warto wymagać od wdrażanego narzędzia dwóch konkretnych zachowań. Po pierwsze, tam gdzie odpowiedź opiera się na firmowej bazie wiedzy, asystent powinien pokazywać źródło. Chodzi o tytuł dokumentu, jego wersję oraz wykorzystany fragment. Dzięki temu pracownik w kilka sekund zweryfikuje, czy odpowiedź pochodzi ze Strefy 1.
Po drugie, narzędzie powinno umieć uczciwie przyznać się do niewiedzy. Zamiast zgadywać, dobry asystent odpowie: „Nie znalazłem zatwierdzonego źródła w tej sprawie”. Taka odpowiedź bywa równie cenna, jak trafna podpowiedź.
Rola Opiekuna Wiedzy w erze algorytmów: Kto pilnuje porządku?
Technologia jest tylko tak sprawna, jak procesy, które nią kierują. Zbudowanie firmowej bazy wiedzy nie jest projektem jednorazowym, lecz ciągłym nawykiem organizacyjnym. W strukturach firmy musi pojawić się rola Opiekuna Wiedzy (Knowledge Master, Data Steward, czy właściciel dokumentacji). Nazwa nie ma znaczenia, dopóki ktoś faktycznie za to odpowiada. Nie musi to być nowo zatrudniony informatyk – tę funkcję świetnie pełni doświadczony menedżer procesów lub szef operacji.
Do zadań Opiekuna Wiedzy należy comiesięczny przegląd raportu zapytań asystenta. Jeśli pracownicy często zgłaszają, że bot nie potrafi odpowiedzieć na pytanie dotyczące nowego produktu, to sygnał, że na dysku brakuje odpowiedniego pliku źródłowego. Opiekun uzupełnia tę lukę, formatuje dokument zgodnie ze standardem i wgrywa go do Strefy 1.
Równie ważnym zadaniem jest usuwanie zdezaktualizowanych wytycznych. Gdy zarząd zmienia warunki współpracy z dostawcami, stary dokument musi natychmiast trafić do Archiwum. Taka dyscyplina sprawia, że cyfrowy mózg firmy rozwija się wraz z rozwojem biznesu.
Praktyczna Checklista Higieny Danych dla Menedżera Procesów

Nie musisz robić wszystkiego od razu. Zacznij od kroku pierwszego. Przejdźmy do konkretnych działań, które możesz wdrożyć w swoim zespole już w tym tygodniu. Oto sześciopunktowa checklista przygotowawcza:
- Inwentaryzacja i czyszczenie dysków: Przejrzyj współdzielone foldery i bezlitośnie przenieś wszystkie pliki ze słowami „kopia”, „draft” oraz „stare” do folderu archiwalnego.
- Wdrożenie metryczek metadanych: Dodaj na początku kluczowych instrukcji blok informacyjny z datą ważności, wersją oraz nazwiskiem osoby odpowiedzialnej.
- Weryfikacja jakości plików (OCR): Upewnij się, że wszystkie zeskanowane dokumenty PDF posiadają aktywną warstwę tekstową umożliwiającą kopiowanie treści.
- Uproszczenie układu graficznego: Przekształć zawiłe, wielokolumnowe tabele w proste listy punktowane opisane pełnymi zdaniami.
- Audyt uprawnień dostępu: Sprawdź, czy asystent AI widzi wyłącznie te dokumenty, do których dostęp miałby dany pracownik również ręcznie, oraz czy dane osobowe klientów są odpowiednio zabezpieczone.
- Ustalenie harmonogramu przeglądów: Wpisz w kalendarz stały, comiesięczny audyt bazy wiedzy, aby na bieżąco usuwać zdezaktualizowane procedury.
Systematyczne realizowanie tych wytycznych zamieni Twoją dokumentację w krystalicznie czyste źródło wiedzy, z którego asystent AI skorzysta z maksymalną precyzją.
Podsumowanie: Zbuduj fundament pod prawdziwą inteligencję
Sztuczna inteligencja w firmie działa dokładnie tak jak lustro – odbija stan organizacji, którą ma wspierać. Jeśli podłączysz zaawansowany model językowy pod chaotyczny, zaśmiecony zbiór dokumentów, otrzymasz spotęgowany chaos i lawinę błędnych decyzji. Gdy jednak poświęcisz czas na uporządkowanie procesów, wdrożenie metadanych i selekcję plików, zyskasz nieocenionego partnera biznesowego.
Budowa cyfrowego mózgu organizacji to proces strategiczny, który zaczyna się od zwykłej dyscypliny w formatowaniu tekstu. Prawidłowa higiena danych to jedna z najtańszych i najskuteczniejszych metod ograniczania błędów wynikających z nieaktualnej, niepełnej lub sprzecznej wiedzy. To jednak fundament, na którym wciąż musi czuwać człowiek. Uporządkuj swoje zasoby już dziś i pozwól technologii pracować na sukces Twojej firmy.
Co dalej? Przejdź od słów do czynów
Większość menedżerów przeczyta ten artykuł, pokiwa głową i odłoży porządkowanie firmowych dysków na bliżej nieokreśloną przyszłość. Ty możesz zyskać przewagę w kilka minut. Aby pomóc Ci szybko przejść od teorii do działania i zdjąć z Ciebie ciężar żmudnych przygotowań, przygotowałem bezpłatny Zestaw Ratunkowy AI. Co znajdziesz w środku?
- Protokół Szybkiego Startu — trzy prompty „kopiuj-wklej”: do pisania postów na LinkedIn, obsługi skrzynki mailowej i zamiany chaotycznych notatek w plan działania. Cel: odzysk około godziny pracy już dziś.
- Skrypt Audytu Czasu — jeden prompt do wklejenia do ChatGPT lub Claude. Dostajesz listę zadań gotowych do automatyzacji, listę tego, czego nie oddawać maszynie, i Quick Wins do wdrożenia w 30 minut.
- Panic Button — pięć komend ratunkowych na wypadek, gdy AI halucynuje fakty, leje wodę, zapętla się w błędzie albo tylko potakuje zamiast krytykować.
Pobierz ten zestaw na start, a co 14 dni na Twoją skrzynkę trafi kolejny, darmowy upgrade Twojego systemu pracy z AI. Zbudowałem to miejsce po to, abyś mógł działać skutecznie na nowym, trudnym rynku.
Źródła i dalsza lektura
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks – oryginalna publikacja naukowa opisująca architekturę RAG (Lewis i in., 2020, ArXiv). Adres: https://arxiv.org/abs/2005.11401
- File search w Responses API – oficjalna dokumentacja OpenAI pokazująca, jak w praktyce działa wyszukiwanie po plikach, indeksowanie, fragmentacja i cytowanie źródeł. Adres: https://platform.openai.com/docs/guides/tools-file-search
- Retrieval-augmented generation (RAG) in Azure AI Search – materiały Microsoft o architekturze RAG, przygotowaniu danych, chunkingu, metadanych, bezpieczeństwie dostępu i jakości wyszukiwania. Adres: Microsoft Azure Docs
- AI Risk Management Framework – wytyczne NIST dotyczące zarządzania ryzykiem AI, nadzoru człowieka i odpowiedzialnego wdrażania systemów sztucznej inteligencji. Adres: NIST Guidelines

