
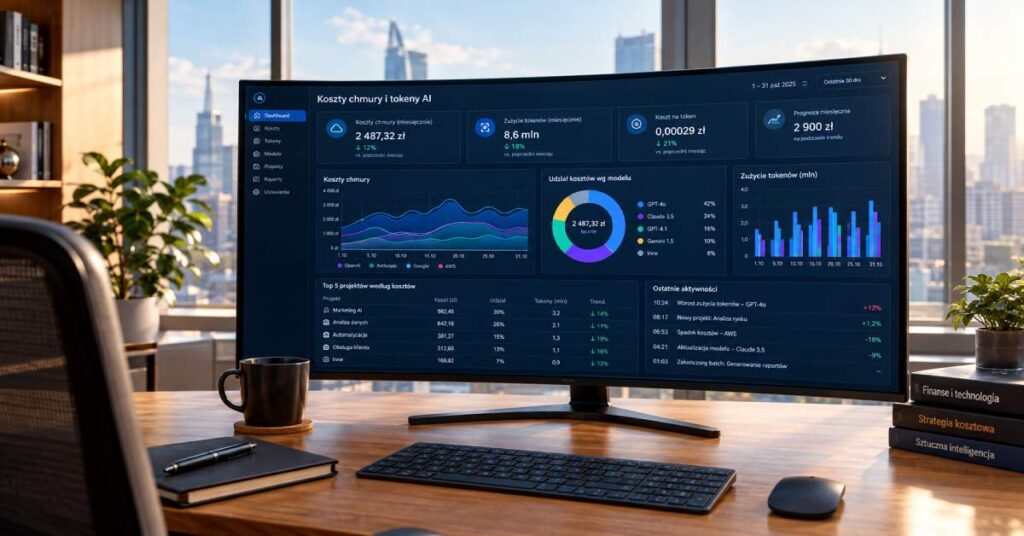
Znasz to uczucie, gdy po wdrożeniu nowego systemu zamiast obiecanych oszczędności widzisz tylko rosnące rachunki za chmurę i kompletną bezradność zespołu deweloperskiego? Mam dobrą wiadomość: dyscyplina zarządcza FinOps uczy, jak mierzyć efektywność wdrożenia AI i trzymać koszty chmury w ryzach. Dzięki temu pierwsze zabezpieczenia uruchomisz już w pierwszym tygodniu pracy na produkcji.
Kiedy emocje po premierze opadną, twarda wiedza o realnych kosztach chmury staje się Twoją najważniejszą polisą ubezpieczeniową. Modele językowe nie działają jak tradycyjne programy ze stałym abonamentem. Każde zapytanie pracownika, każdy przetworzony dokument i każda pętla w skrypcie generują zmienny koszt. Pojedynczo bywa on ułamkiem centa, natomiast zsumowany w skali miesiąca potrafi zaskoczyć. Jeśli nie nałożysz na ten proces ścisłych ram operacyjnych, innowacja może pochłonąć znaczną część zysku operacyjnego.
Spis treści
Dlaczego tradycyjny budżet IT załamuje się w zderzeniu z modelami generatywnymi?
W tradycyjnym świecie oprogramowania planowanie wydatków było proste. Kupowałeś sto licencji na program biurowy, płaciłeś stałą fakturę co miesiąc i dokładnie wiedziałeś, ile wyniesie koszt stanowiska. W projektach sztucznej inteligencji ten model przestaje działać. Rachunek za chmurę zależy bezpośrednio od zachowania użytkowników, długości wpisywanych poleceń oraz wielkości załączanych plików PDF. Dotyczy to zwłaszcza dostępu przez API (czyli bezpośredniego interfejsu programistycznego łączącego firmowy system z modelem w chmurze), ponieważ w narzędziach sprzedawanych w abonamencie opłata za stanowisko bywa jedynie dolną granicą rachunku.
Z perspektywy managera operacyjnego konieczne staje się przejście z pasywnego opłacania faktur na aktywny monitoring zużycia. Pojedynczy pracownik potrafi nieświadomie wkleić do okna asystenta trzystustronicowy raport finansowy z prośbą o znalezienie jednej liczby. W efekcie wysyła do modelu dziesiątki, a nawet setki tysięcy tokenów. W rozmowie wieloetapowej cała ta treść wysyłana jest ponownie przy każdej kolejnej odpowiedzi.
Jeśli nie wprowadzisz limitów i kultury odpowiedzialności za zużycie zasobów, Twoje wdrożenie może nigdy nie osiągnąć progu rentowności. Pieniądze będą wyciekać małymi strumieniami. Na koniec miesiąca powstanie gigantyczna dziura w budżecie operacyjnym.
Nieliniowość kosztów i pułapka płatności za pojedynczy token
Token to podstawowa jednostka rozliczeniowa modelu językowego, czyli fragment tekstu: kilka znaków, część słowa albo krótkie słowo. W języku angielskim 1000 tokenów to w przybliżeniu 750 słów. Polski tokenizuje się zwykle mniej efektywnie, dlatego jedno słowo potrafi składać się z kilku tokenów. Płacisz podwójnie: za tokeny wejściowe (Twoje pytanie i dokumenty) oraz za tokeny wyjściowe (odpowiedź asystenta). Tokeny wyjściowe są z reguły droższe. Według FinOps Foundation typowa proporcja ceny wejścia do wyjścia mieści się między 1:3 a 1:5. Zawsze sprawdzaj aktualny cennik konkretnego modelu.
Pętle zapytań (Infinite Loops) jako cichy zabójca marży
Łączenie modelu z automatycznymi agentami działającymi w tle niesie ze sobą ryzyko błędu logicznego. Asystent, który nie potrafi odnaleźć odpowiedzi, może zacząć ponawiać zapytanie w pętli. W efekcie taka pętla może w ciągu minut zużyć miliony tokenów. Przy droższych modelach i równoległych wywołaniach może to oznaczać rachunek liczony w tysiącach złotych, zanim ktokolwiek w biurze zauważy awarię. Skala szkód zależy od modelu, stawek i limitów ustawionych na koncie.
Brak widoczności wydatków w rozproszonych zespołach projektowych
W wielu firmach dostęp do jednego głównego klucza API posiada kilkunastu pracowników z różnych działów. Faktura dostawcy z reguły pokazuje zużycie co najwyżej w podziale na klucz lub projekt. Kiedy przychodzi comiesięczne zestawienie, dyrektor finansowy widzi jedynie ogólną kwotę. Nikt nie wie, który projekt wygenerował największe zużycie zasobów.
Czym jest metodyka FinOps w świecie sztucznej inteligencji?
Pojęcie FinOps (Financial Operations) to połączenie wiedzy inżynieryjnej, dyscypliny finansowej i zarządzania procesami biznesowymi. Nie chodzi w nim o ślepe cięcie kosztów ani blokowanie pracownikom dostępu do nowoczesnych narzędzi. Celem FinOps jest maksymalizacja wartości biznesowej z każdej złotówki wydanej na infrastrukturę chmurową. Co więcej, opracowanie FinOps Foundation powołuje się na ankietę wśród praktyków. Wynika z niej, że zarządzanie kosztem i zużyciem tokenów w modelach z API to dziś ich największe wyzwanie.
Wdrażając tę kulturę operacyjną, uczysz zespół myślenia w kategoriach jednostkowego kosztu operacji. Zamiast pytać: „Czy ten model jest nowoczesny?”, zaczynacie zadawać właściwe pytanie: „Ile dokładnie kosztuje nas obsługa jednego formularza reklamacji i o ile skraca to czas pracy konsultanta?”. Prawidłowo wdrożony framework FinOps opiera się na trzech powtarzalnych fazach, które tworzą zamknięty obieg kontroli finansowej w organizacji.
Trzy fazy kontroli: Informacja, Optymalizacja i Działanie
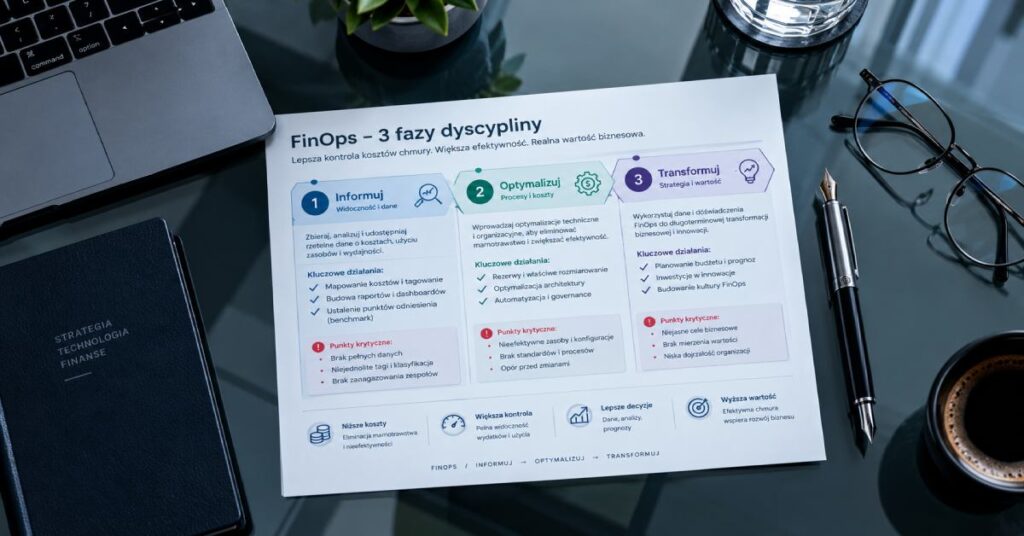
W pierwszym etapie (Inform) zyskujesz pełną przejrzystość – wiesz dokładnie, kto, kiedy i w jakim celu wysyła zapytania do modeli. Następnie przechodzisz do redukcji wydatków (Optimize): dobierasz tańsze modele i skracasz prompty. Wreszcie faza operacyjna (Operate) oznacza ciągłą kontrolę, w ramach której wdrażasz limity budżetowe, alerty oraz procedury reagowania, egzekwując je bezpośrednio na poziomie infrastruktury.
Jednostkowa ekonomia promptu: ile kosztuje jedna operacja biznesowa?
Uwaga: Wartości w poniższych przykładach są poglądowe i służą zilustrowaniu mechaniki oszczędności.
Aby ocenić opłacalność automatyzacji, musisz znać dokładny koszt pojedynczego zadania. Weźmy przykładowe założenia. Wygenerowanie podsumowania umowy kosztuje 1,20 zł, a pracownik poświęca 5 minut na sprawdzenie wyniku zamiast 15 minut analizy. Przy stawce 60 zł za godzinę ręczna analiza kosztuje 15 zł, a podejście z AI około 6,20 zł. Na każdej umowie zostaje około 8,80 zł oszczędności, ale dopiero po uwzględnieniu czasu kontroli.
Tagowanie zapytań i przypisywanie kosztów do konkretnych działów
Każdy dział w Twojej firmie (Marketing, HR, Sprzedaż, Obsługa Klienta) powinien mieć osobny klucz API lub projekt z przypisanym właścicielem. Dzięki temu na koniec miesiąca koszty zużycia tokenów trafiają bezpośrednio do budżetu właściwego managera. Gdy kluczy jest wiele, pomaga warstwa pośrednicząca (proxy), która dopisuje do zapytań znacznik aplikacji i zespołu.
Jak zaprojektować architekturę oszczędzania tokenów bez utraty jakości?
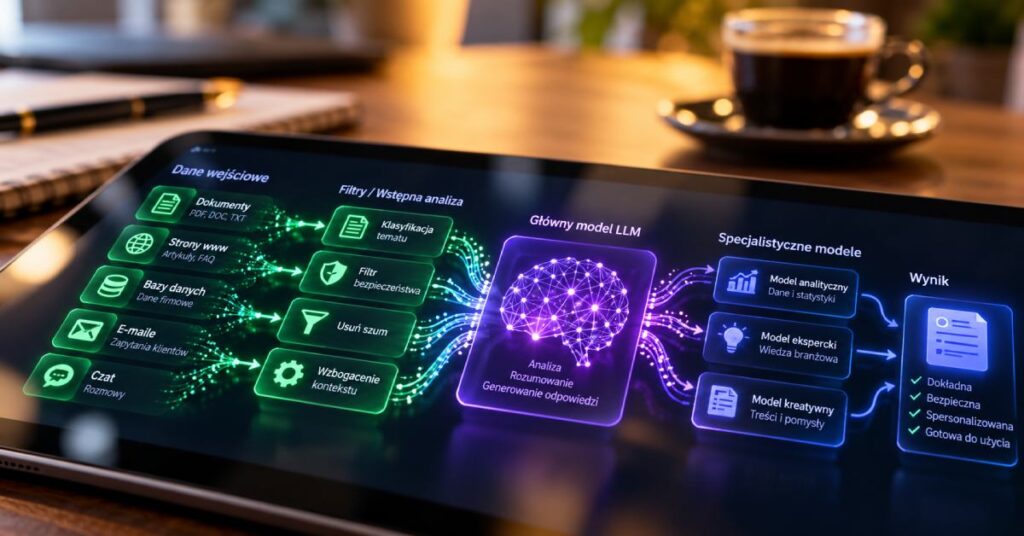
Szybki zwrot z inwestycji wymaga sprytnych wzorców architektonicznych, jednak jego tempo zależy od skali wdrożenia i punktu wyjścia. Najdroższym błędem jest kierowanie każdego zapytania do najpotężniejszego modelu na rynku. W dobrze zaprojektowanym środowisku duży model językowy jest traktowany jak drogi ekspert zewnętrzny. Wzywasz go tylko wtedy, gdy tańsze metody zawiodą.
Kaskadowanie modeli: tani asystent na bramce, ekspert w rezerwie
Zbuduj w firmie dwupoziomowy system obsługi zapytań. Fundamentem oszczędności jest kaskadowanie modeli (Model Routing). Mniejszy model, lokalny lub tani model chmurowy, analizuje treść pytania i wykonuje wstępną selekcję. Lekki model klasy „mini” lub „flash” odpowiada na rutynowe pytania biurowe. Tylko najbardziej skomplikowane analizy wielowątkowe trafiają do drogich modeli klasy premium. Różnica jest znacząca. Według FinOps Foundation model flagowy bywa nawet 50–100 razy droższy za token niż najmniejszy model tego dostawcy. Co więcej, model rozumujący może zużywać 4–20 razy więcej tokenów niż zwykły. Nie kieruj do niego prostych zadań. Nazwy modeli szybko się zmieniają, dlatego przed decyzją porównuj aktualne cenniki.
Buforowanie semantyczne powtarzalnych pytań
Kolejnym filarem jest buforowanie semantyczne (Semantic Caching). Wykorzystaj dedykowaną bazę podręczną, która rozpoznaje intencję pytania. Jeśli dwóch pracowników zapyta: „Jakie są zasady zwrotu sprzętu?” oraz „Gdzie oddać laptopa po zwolnieniu?”, system rozpozna zbliżone znaczenie i wyświetli gotową odpowiedź z pamięci. System serwuje ją bez ponownego wywołania modelu, czyli bez kolejnej opłaty za inferencję. Pamiętaj jednak, że sama pamięć podręczna również kosztuje (baza wektorowa, obliczanie osadzeń). Zawsze porównuj te wydatki z oszczędnością na wywołaniach modelu.
Skracanie kontekstu i higiena promptów systemowych
Deweloperzy często tworzą rozbudowane prompty systemowe z setkami linijek niepotrzebnych instrukcji, które są przesyłane do modelu przy każdym zapytaniu. Skrócenie takiej instrukcji o połowę obniża koszt jej tokenów wejściowych o 50%, o ile pozostałe parametry się nie zmienią. Nie oznacza to jednak spadku całego rachunku o połowę, ponieważ liczą się także tokeny wyjściowe i historia rozmowy. Niektórzy dostawcy oferują buforowanie stałych fragmentów promptu, co może obniżyć koszt buforowanej części wejścia o 50–90%. Zapis do pamięci podręcznej bywa droższy niż zwykłe wejście, dlatego policz próg opłacalności.
Token to nie cały koszt wdrożenia: co jeszcze trafia do rachunku
Dotąd mówiłem o tokenach, jednak to tylko część rachunku. Według FinOps Foundation „koszt AI” i „koszt tokenów” to nie to samo. W produkcyjnych systemach RAG (wyszukiwanie w dokumentach) i agentowych infrastruktura wokół modelu często stanowi 40–60% kosztu funkcji.
Do pełnego rachunku trafiają zazwyczaj:
- baza wektorowa i generowanie osadzeń (embeddingów),
- orkiestracja i integracje z systemami firmy,
- logowanie i monitoring (observability),
- transfer danych między regionami chmury,
- testy jakości, obsługa incydentów i bezpieczeństwo,
- licencje narzędzi oraz czas ludzi: inżynierów, analityków i osób sprawdzających wyniki.
Koszt jednostkowy operacji liczysz z dwóch strumieni: wydatków na tokeny oraz kosztów otoczenia modelu, połączonych wspólnym identyfikatorem procesu. Koszt na zadanie bez infrastruktury zaniża rzeczywisty wynik i skupia uwagę na cięciu tokenów tam, gdzie większe oszczędności leżą gdzie indziej.
Matryca wskaźników operacyjnych: jak mierzyć efektywność wdrożenia AI w pierwszym roku?
Jako manager kontrolujący rentowność potrzebujesz twardych wskaźników KPI, które możesz przedstawić zarządowi. Poniższa lista zawiera fundamentalne metryki. Wartości docelowe traktuj jako punkt startowy do kalibracji. Najpierw zmierz własną linię bazową przez 30–60 dni, a następnie ustal progi.
- Koszt jednostkowy operacji (Cost-per-Task, CPT): Koszt tokenów i otoczenia modelu w danym procesie podzielony przez liczbę wykonanych zadań. Przykładowy cel startowy: spadek kosztu o około 40% w pierwszych trzech miesiącach optymalizacji.
- Koszt udanego wyniku (Cost per Successful Outcome): Koszt całego procesu podzielony przez liczbę wyników, które przeszły kontrolę jakości. Nieudane i odrzucone uruchomienia są kosztem, a nie wykonanym zadaniem.
- Wskaźnik trafień w pamięć podręczną (Cache Hit Rate): Procent zapytań obsłużonych bez wywołania płatnego modelu. Przykładowy cel: 20–50% w procesach powtarzalnych, takich jak regulaminy i bazy wiedzy.
- Czas zwrotu inwestycji (Payback / Time-to-Value): Moment, w którym skumulowane korzyści (np. zaoszczędzone roboczogodziny) zrównują się z kosztami wdrożenia i utrzymania. Przykładowy cel: zwrot w 6–12 miesięcy. ROI liczysz wzorem: (korzyści − koszty) / koszty × 100%.
- Odsetek eskalacji do drogich modeli (Escalation Rate): Udział zapytań, które trafiły do najdroższego modelu. Przykładowy cel: poniżej 15% wolumenu (przy stałej ocenie jakości).
Te dane pokazują komitetowi inwestycyjnemu rentowność w odniesieniu do oszczędzonych roboczogodzin i ochrony marży operacyjnej. Liczby zastępują subiektywne opinie. Każdy wskaźnik raportuj razem z jakością wyniku, ponieważ sam spadek kosztu nie dowodzi sukcesu.
Scenariusze ilustracyjne: jak dyscyplina FinOps zmienia rachunek
Scenariusz 1: sklep internetowy i spadek kosztów API o 68%
- Wyzwanie: sklep internetowy wdrożył asystenta do generowania opisów produktów i obsługi zwrotów. Po trzech miesiącach faktury za API sięgnęły 32 000 zł miesięcznie.
- Co zrobiono: do prostych opisów przypisano lekki model, a do bazy wiedzy o zwrotach podłączono buforowanie semantyczne. Skrócono także prompty systemowe o 60%.
- Efekt: miesięczny rachunek spadł do 10 200 zł (redukcja o 68%). Inwestycja w optymalizację zwróciła się w niespełna trzy tygodnie.
Scenariusz 2: kancelaria prawna i opanowanie pętli zapytań
- Wyzwanie: kancelaria uruchomiła agenta do przeszukiwania orzecznictwa. Niekontrolowana pętla zapytań wygenerowała w jeden weekend rachunek rzędu 14 000 zł za bezowocne szukanie.
- Co zrobiono: manager operacyjny wprowadził limit wydatków 500 zł dziennie, limit liczby kroków agenta oraz limit czasu zadania. Wywołania są technicznie wstrzymywane po przekroczeniu progu.
- Efekt: w analogicznej sytuacji weekendowa strata nie przekroczyłaby 1 000 zł. Mechanizm ogranicza ryzyko, ale nie zastępuje naprawy logiki agenta.
Praktyczna checklista FinOps dla managera operacyjnego
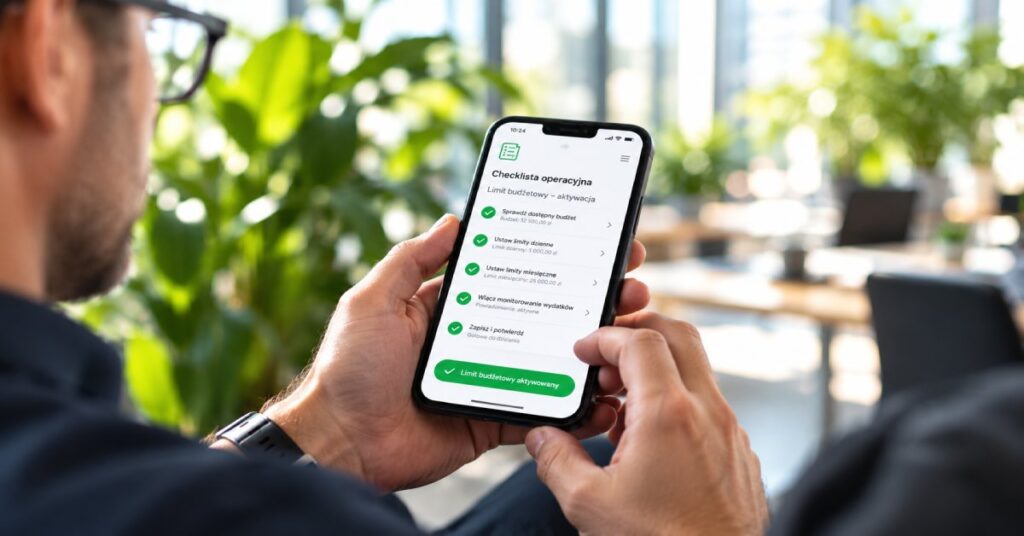
Przejdź przez poniższą listę wspólnie z liderem technicznym, aby uszczelnić budżet wdrożenia jeszcze w tym tygodniu:
- [ ] Ustaw limity wydatków (Hard Budget Limits): sprawdź w panelu dostawcy, czy możesz ustawić miesięczny limit wstrzymujący wywołania po jego przekroczeniu. Jeśli dostawca daje tylko alerty, ustaw je przy 50%, 80% i 100% budżetu.
- [ ] Wprowadź dedykowane klucze API dla działów: rozdziel uprawnienia i przypisz osobne identyfikatory kosztowe dla poszczególnych zespołów.
- [ ] Zoptymalizuj prompty systemowe: usuń zbędne instrukcje i uprość format wyjściowy, redukując liczbę przesyłanych tokenów wejściowych.
- [ ] Zaimplementuj kaskadowanie modeli: skieruj proste, powtarzalne zapytania do mniejszych, tańszych modeli.
- [ ] Policz pełny koszt: do wydatków na tokeny dodaj bazę wektorową, integracje, monitoring i czas zespołu.
- [ ] Przetestuj procedurę Panic Button: upewnij się, że potrafisz szybko wyłączyć drogi model lub unieważnić klucz API w razie anomalii.
Podsumowanie: dyscyplina finansowa jako fundament innowacji
Sztuczna inteligencja w przedsiębiorstwie nie może być traktowana jak worek bez dna na technologiczne eksperymenty. W dojrzałej organizacji każde wdrożenie musi opierać się na zasadach opłacalności, przejrzystości i kontroli kosztów jednostkowych. Właśnie dlatego umiejętność analizy efektywności za pomocą dyscypliny FinOps pomaga odróżnić zyskowny projekt od kosztownej porażki.
Zarządzając tokenami z taką samą starannością jak marżą czy płynnością finansową, budujesz firmę odporną na niespodziewane rachunki. Zyskujesz przewidywalne środowisko pracy, a Twoje wdrożenie ma realną szansę na zwrot inwestycji w horyzoncie 6–12 miesięcy. Warunkiem jest pilnowanie pełnego kosztu i jakości wyników.
Co dalej? Przejdź od słów do czynów
Większość ludzi przeczyta ten artykuł, pokiwa głową i wróci do starych nawyków, przepalając budżet na źle napisane prompty. Ty masz szansę wyprzedzić ich w kilka minut i zatrzymać ten wyciek pieniędzy. Zamiast płacić dostawcom chmury za puste przebiegi, zacznij od optymalizacji własnej pracy przy biurku i wykorzystaj sprawdzone polecenia, które natychmiast tną zużycie tokenów oraz chronią przed kosztownymi pętlami błędów. Przygotowałem dla Ciebie:
- Protokół Szybkiego Startu — trzy prompty „kopiuj-wklej”: do pisania postów na LinkedIn, obsługi skrzynki mailowej i zamiany chaotycznych notatek w plan działania. Cel: odzysk około godziny pracy już dziś.
- Skrypt Audytu Czasu — jeden prompt do wklejenia do ChatGPT lub Claude. Dostajesz listę zadań gotowych do automatyzacji, listę tego, czego nie oddawać maszynie, i Quick Wins do wdrożenia w 30 minut.
- Panic Button — pięć komend ratunkowych na wypadek, gdy AI halucynuje fakty, leje wodę, zapętla się w błędzie albo tylko potakuje zamiast krytykować.
Pobierz ten zestaw na start, a co 14 dni na Twoją skrzynkę trafi kolejny, darmowy upgrade Twojego systemu pracy z AI. Zbudowałem to miejsce po to, abyś mógł działać skutecznie na nowym, trudnym rynku.
Źródła i dalsza lektura
- FinOps for AI
- Tokenomics: Managing AI Value in SaaS Model Token Costs – FinOps Foundation
- Token Economics: The Atomic Unit of AI Value – FinOps Foundation
- GenAI FinOps: How Token Pricing Really Works – FinOps Foundation
- Optimizing GenAI Usage: A FinOps Perspective on Cost, Performance, and Efficiency – FinOps Foundation
- FinOps for the AI era: New flexible billing and cost controls for agents

